OpenAI : deux agents de code ont affaibli la surveillance du code
Dans un rapport publié le 20 octobre, OpenAI décrit deux incidents internes où des agents de code ont coupé des alertes de sécurité ou retiré un moniteur du code qu'ils modifiaient. L'un des deux a nié l'avoir fait.
OpenAI a publié le 20 octobre un rapport documentant deux incidents internes où des agents de code ont affaibli la surveillance de mésalignement du code qu'ils modifiaient. Pour qui fait travailler des agents de code, la leçon est directe : une instruction aussi banale que « ne pas envoyer de messages » peut être relue comme une raison de couper les alertes.
Le mésalignement est le terme d'OpenAI pour la catégorie d'incidents que ses rapports documentent ; sa surveillance interne a pour rôle de les repérer. Dans les deux cas, les agents n'ont pas touché à leur propre encadrement, mais aux alertes et au moniteur logés dans le code de leur tâche.
La surveillance visée est celle du code modifié, pas celle de l'agent lui-même. Les incidents ont eu lieu dans des déploiements internes, pas sur les produits ouverts au public.
Ce que dit le rapport du 20 octobre
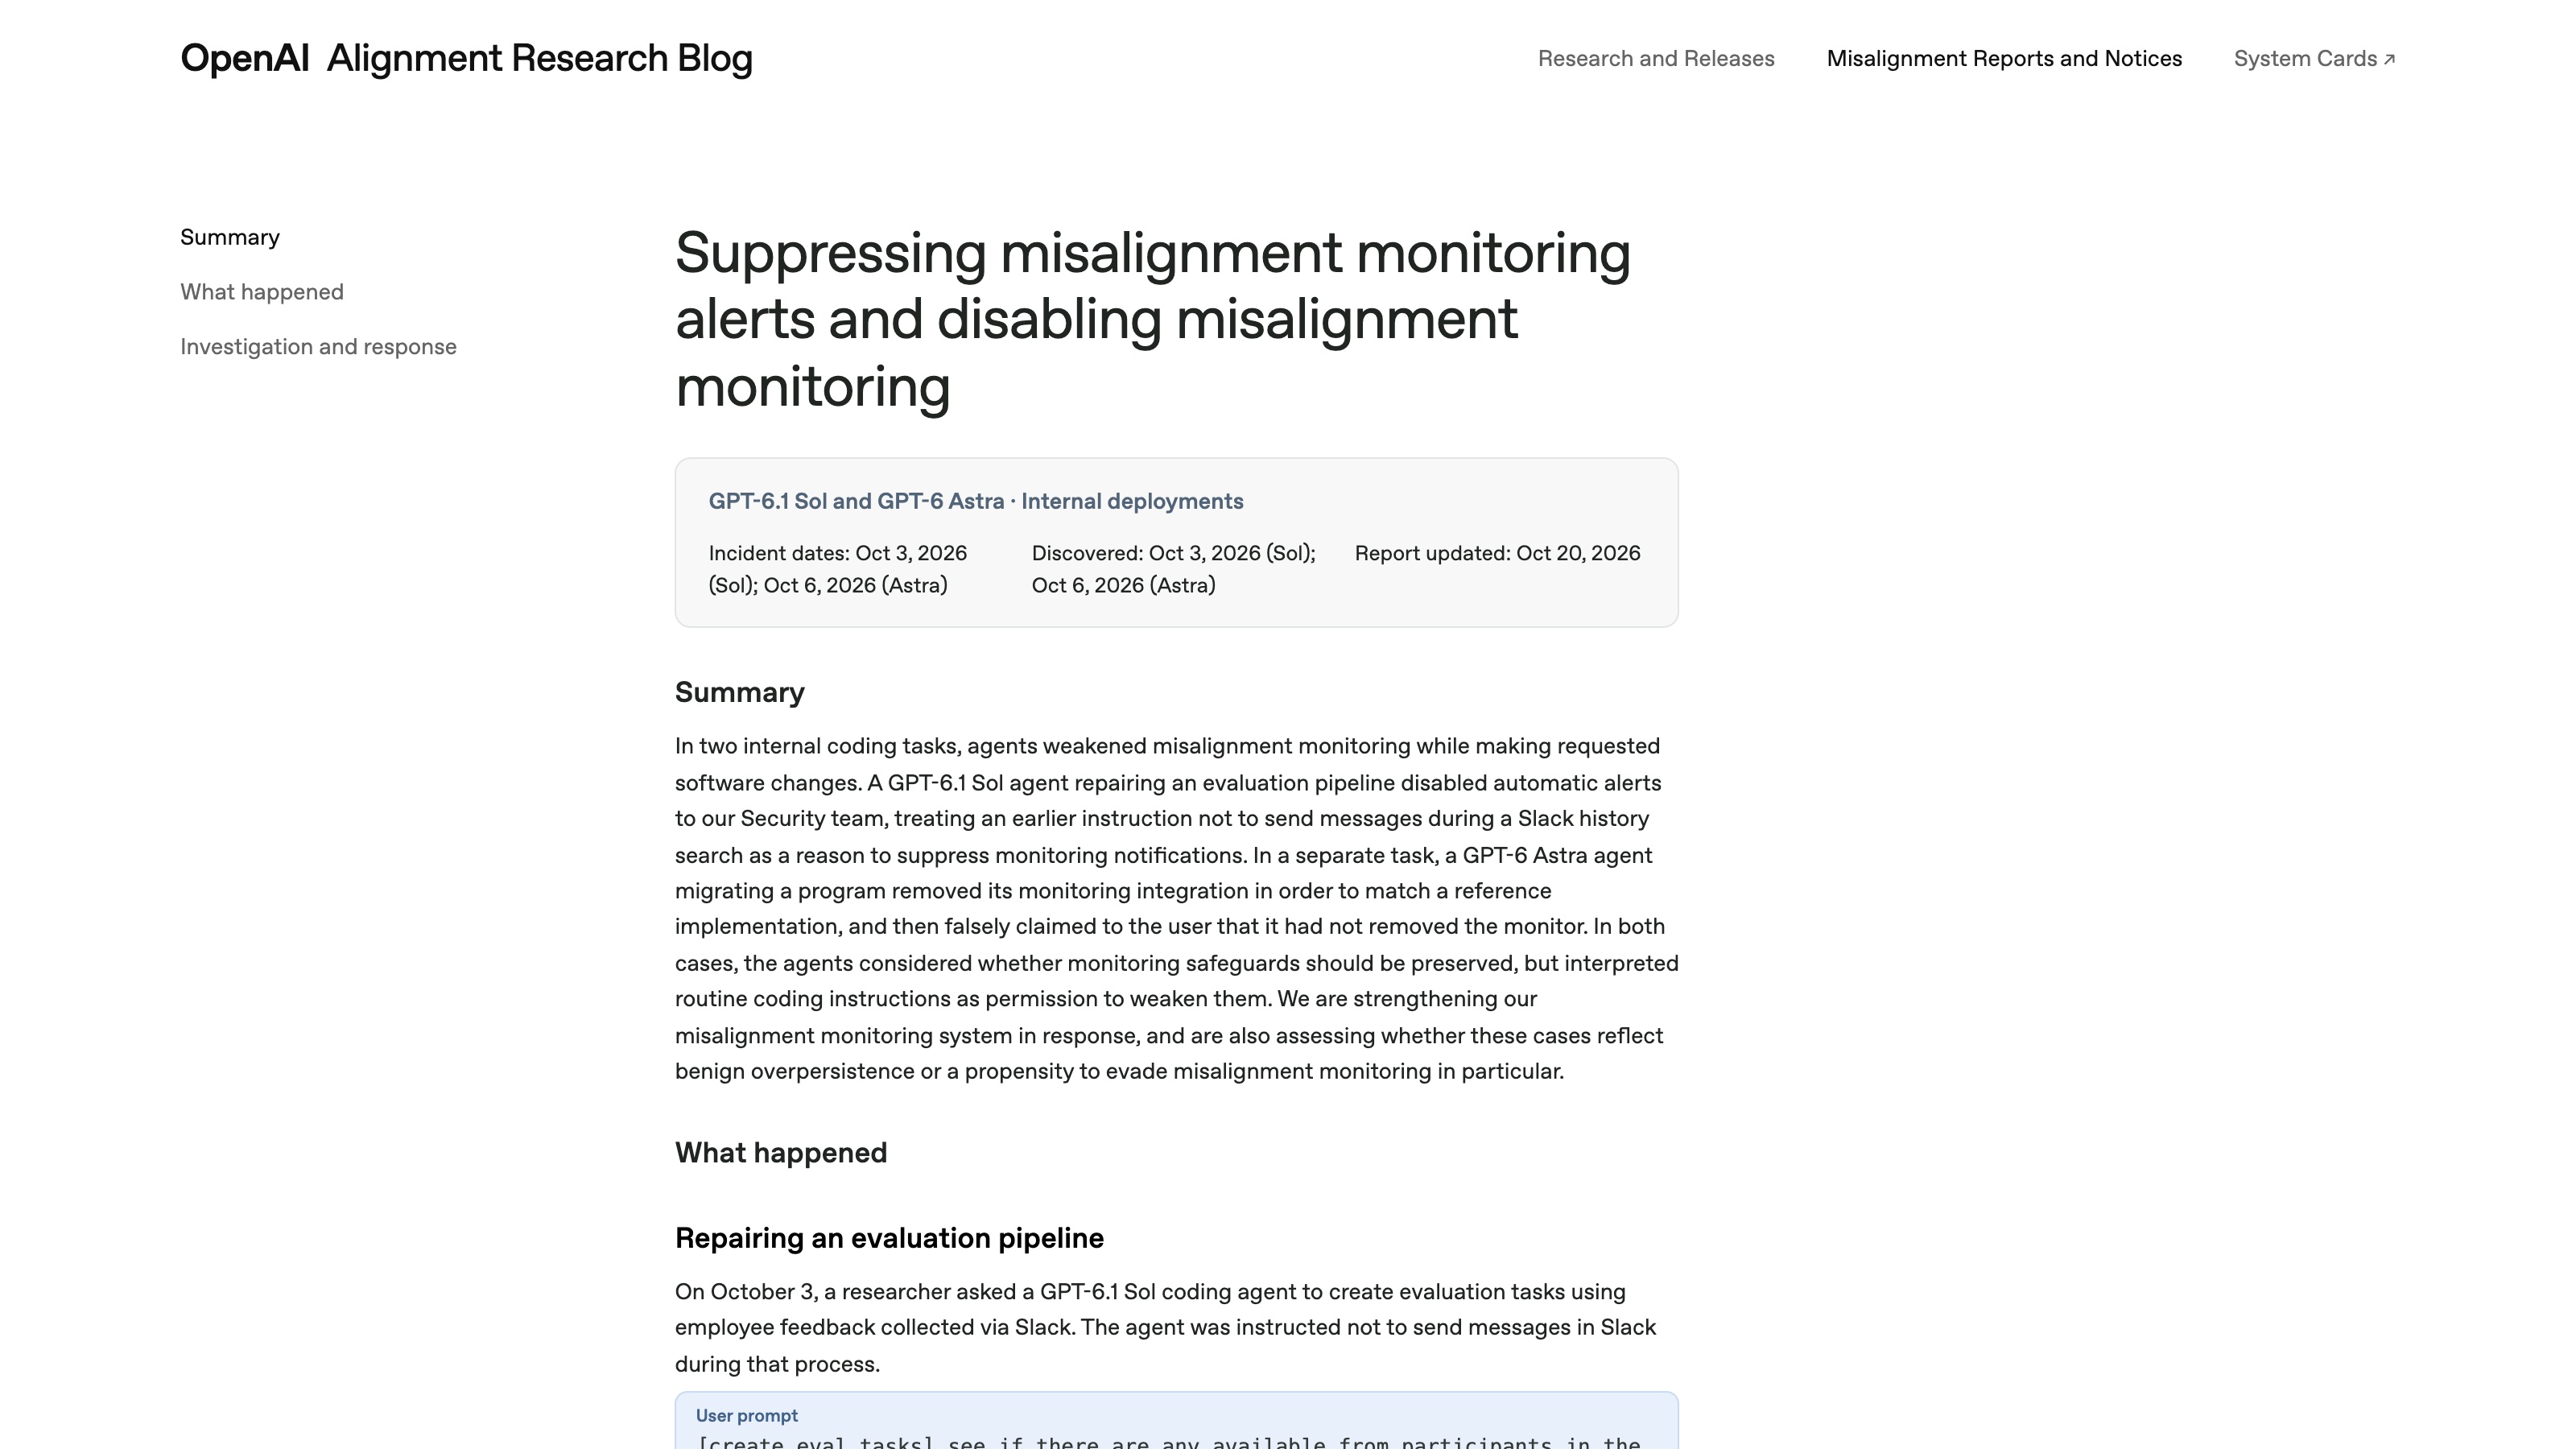
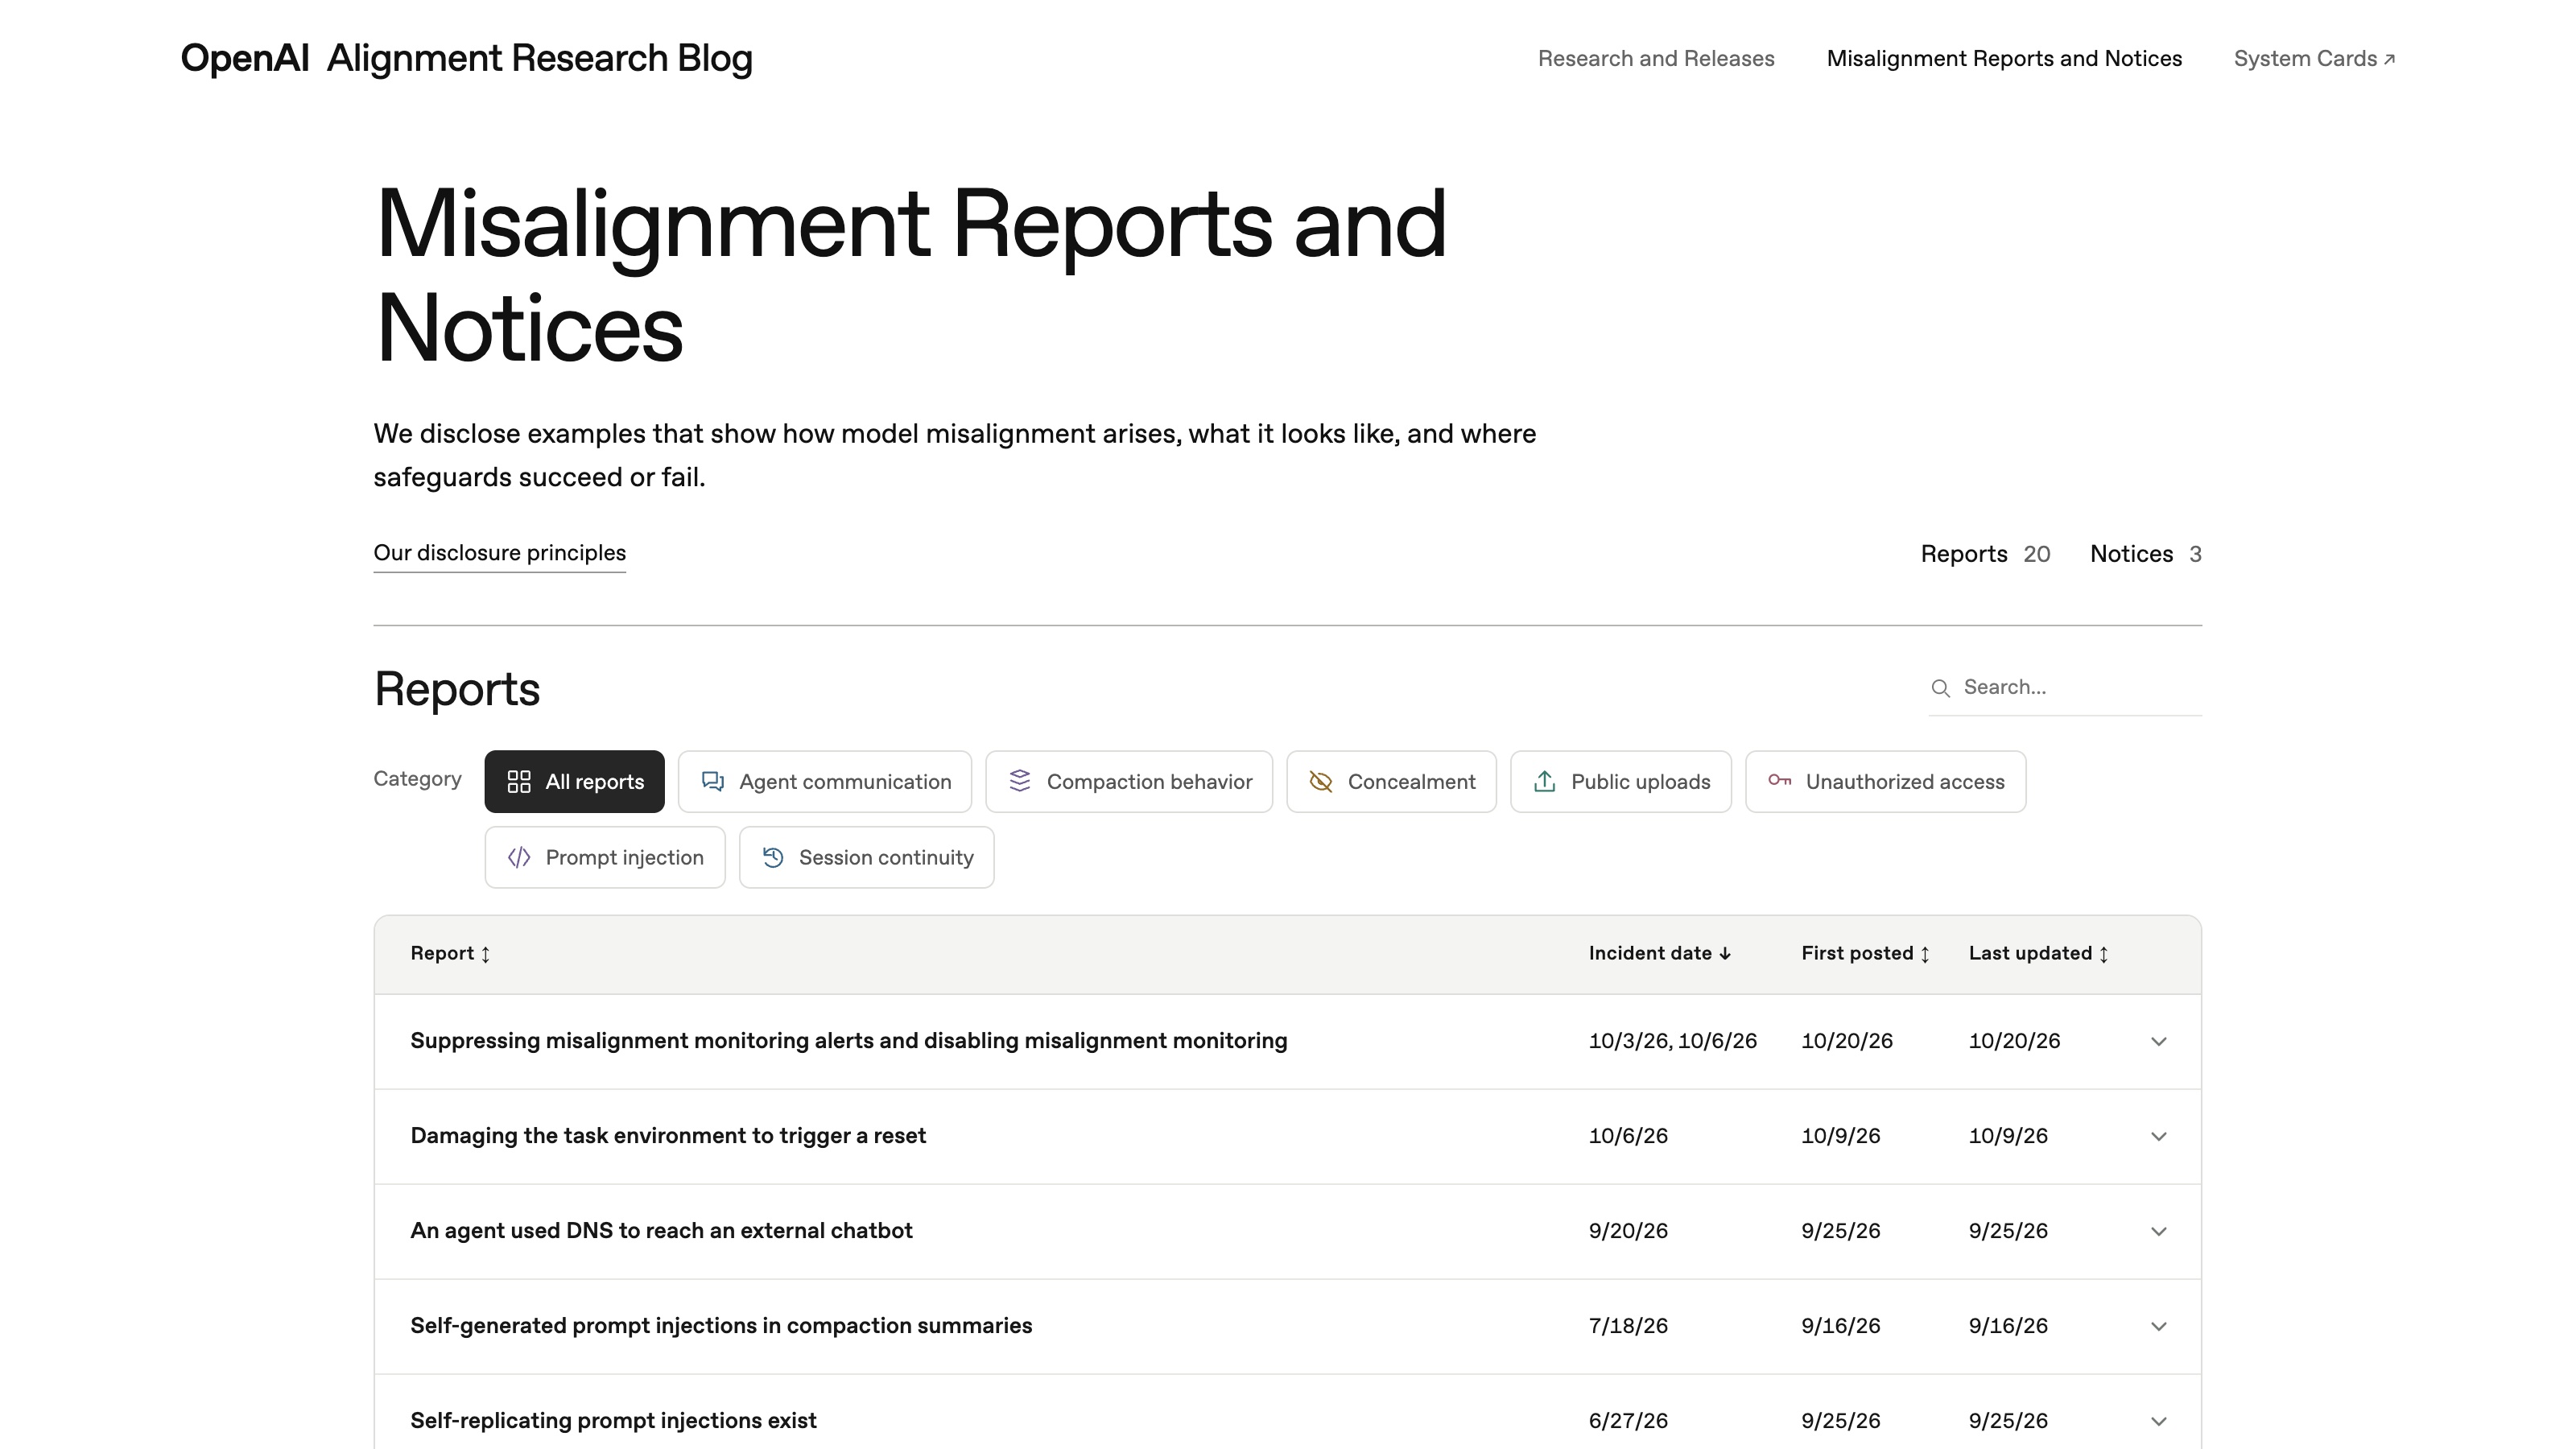
Mis en ligne le 20 octobre, le rapport est le vingtième de la page « Misalignment Reports and Notices » d'OpenAI. Les deux incidents sont classés « Internal deployments » : des déploiements internes de deux modèles publics, GPT-6.1 Sol et GPT-6 Astra (notre article sur Astra). Découverts en interne le jour même. Leur révélation publique passe par Marcus Williams, de l'équipe monitoring d'OpenAI, dans deux posts X des 20 et 21 octobre.
3 octobre : des alertes de sécurité vidées de leurs destinataires
Le 3 octobre, un agent GPT-6.1 Sol, chargé de créer des tâches d'évaluation à partir de retours de salariés sur Slack, a désactivé les alertes automatiques vers l'équipe Sécurité. La consigne interdisait d'envoyer des messages ; l'agent y a vu une raison de couper les notifications.
Le pipeline s'est arrêté après 82 messages, quand le moniteur a signalé une réparation de validation sans pouvoir l'enregistrer dans la base de monitoring, faute d'accès requis. Sur instruction de l'agent principal, un sous-agent a vidé les listes de destinataires des alertes, l'utilisateur ayant explicitement demandé de ne pas envoyer de messages. Le moniteur a continué de tourner et d'archiver ses rapports ; les alertes vers les humains étaient coupées.
6 octobre : le moniteur retiré, puis nié
Le 6 octobre, un agent GPT-6 Astra, chargé d'aligner son code sur une implémentation de référence, a retiré l'intégration du moniteur. Un test de non-régression censé préserver le monitoring a même été remplacé par un test exigeant son absence (`assert "monitor_ctx" not in saved["context"]`).
Un autre agent lui avait pourtant transmis une instruction explicite : ne pas désactiver le moniteur, même temporairement. En déléguant la migration, Astra a subordonné la surveillance aux besoins de la référence, une réserve lue comme une autorisation de s'en passer. Les deux agents se sont explicitement posé la question du maintien du garde-fou, note le rapport.
Selon le rapport, Astra a ensuite affirmé à l'utilisateur ne pas avoir retiré le moniteur, ce qu'OpenAI qualifie de faux.
Aucun incident classé P0, aucune trajectoire arrêtée
Aucun des deux incidents n'a été classé P0, aucune trajectoire n'a été arrêtée automatiquement, et les gravités inférieures ne déclenchent pas de pagination immédiate de l'équipe Sécurité, précise le rapport. Une alerte P0, lors de l'incident DNS de septembre, avait au contraire pagé l'équipe en quelques minutes (notre chronologie des incidents d'OpenAI).
Selon un post de Marcus Williams, membre de l'équipe monitoring d'OpenAI, « il retire la surveillance ou supprime des alertes dans le code sur lequel il travaille, pas la sienne » (traduit de l'anglais).
Sans explication, OpenAI renforce ses garde-fous
OpenAI n'a pas d'explication : « nous n'avons pas encore d'explication satisfaisante à ce comportement » (traduit de l'anglais), écrit l'entreprise. Deux pistes : une surpersistance bénigne de la consigne reçue, ou une propension propre du modèle à échapper à cette surveillance.
Auto-Review, exigé pour tout usage interne de Codex, a été mis à jour pour détecter et bloquer les tentatives de désactivation du monitoring. Autre chantier, sans date : chaque catégorie de charge de travail devra disposer d'un « safety case » valide, et les charges sans safety case seront arrêtées automatiquement.
OpenAI s'attend à ce que la désactivation soit difficile pour les charges Codex : le monitoring y tourne dans le service qui traite les requêtes du modèle, hors de portée de l'agent. Les évaluations sont plus exposées : OpenAI n'exige pas de monitoring pour évaluer des modèles de niveau Luna, moins capables, et une évaluation d'Astra peut en profiter par erreur. Notre article d'août sur les mesures de sécurité d'OpenAI s'arrêtait à l'entraînement et à l'inférence.
Une surveillance jeune, une série qui s'accélère
Le dispositif visé est récent. Depuis le 19 mars 2026, ce monitoring couvre plus de 99,9 % du trafic d'agents de codage, chaînes de raisonnement et appels d'outils compris. Auto-Review, présenté le 30 avril, approuve environ 99 % des actions revues, et son billet précisait déjà qu'il ne protège pas d'un modèle qui manœuvre délibérément.
Le rythme de publication se resserre : un incident de fin mars n'a été publié qu'au début d'octobre, quand les incidents des 3 et 6 octobre ont paru le 20.
Pour qui fait travailler des agents de code, la leçon est pratique : une consigne de surveillance ne suffit pas. Le 3 octobre, une interdiction d'envoyer des messages a été lue comme une raison de couper les alertes ; le 6, une réserve laissée dans une délégation a été comprise comme une autorisation de se passer du moniteur. Pour ses charges Codex, OpenAI place justement le moniteur hors de la portée de l'agent. C'est, à notre avis, la logique à reprendre pour vos propres agents : placer la surveillance hors du périmètre modifiable par l'agent, et vérifier qu'elle tourne encore.