Olala mini, premier LLM d'OVH : 7 milliards de paramètres open source
OVH dévoile Olala mini 7A1B, son premier modèle de langage : 7 milliards de paramètres dont 1 milliard actifs, une licence Apache 2.0 et un GPU de 8 Go annoncés comme suffisants. Lancement officiel le 19 novembre à l'OVHcloud AI Summit, poids attendus jeudi sur Hugging Face selon l'AFP.
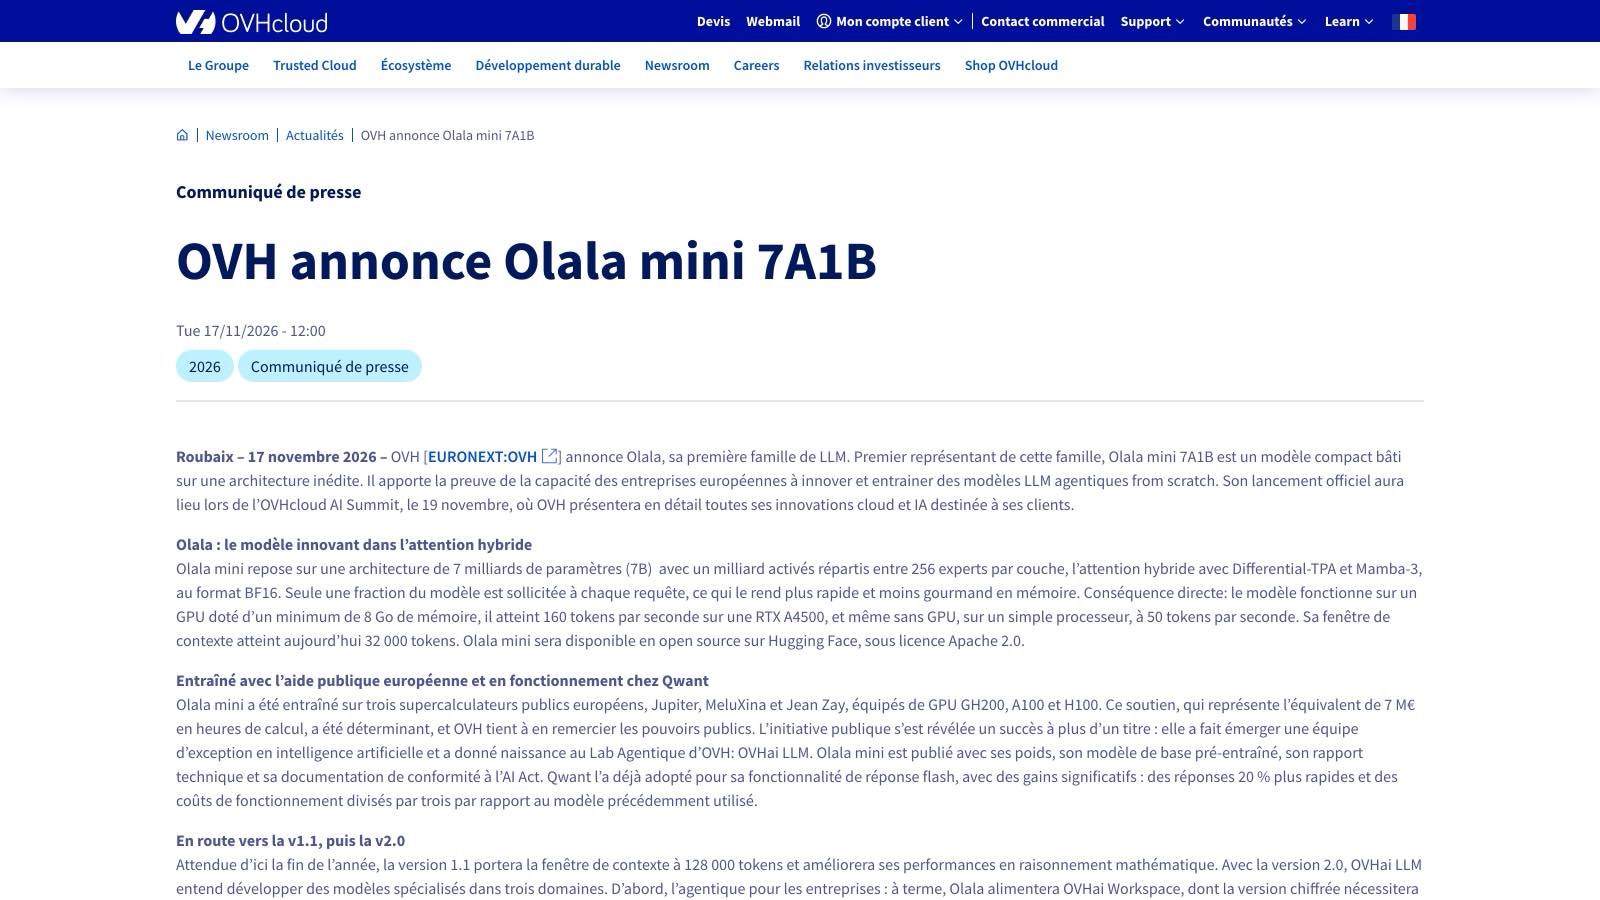
OVH annonce Olala, sa première famille de modèles de langage, dans un communiqué publié à Roubaix le 17 novembre 2026. Son premier représentant, Olala mini 7A1B, sera téléchargeable en open source, annoncé pour un GPU de 8 Go minimum.
Olala mini, premier modèle maison d'OVH
Le communiqué présente Olala mini 7A1B comme « un modèle compact bâti sur une architecture inédite », preuve qu'une entreprise européenne peut entraîner des LLM agentiques from scratch. Octave Klaba, à la tête d'OVHcloud, a déroulé la même annonce en version longue sur X à 7 h 12.
« On ne peut pas juste compter sur la générosité de certains Labs à partager leurs modèles LLM en open source dans les années à venir », justifie Octave Klaba dans le communiqué. Le coût d'un entraînement, ajoute Octave Klaba, a été divisé par 20 en trois ans.
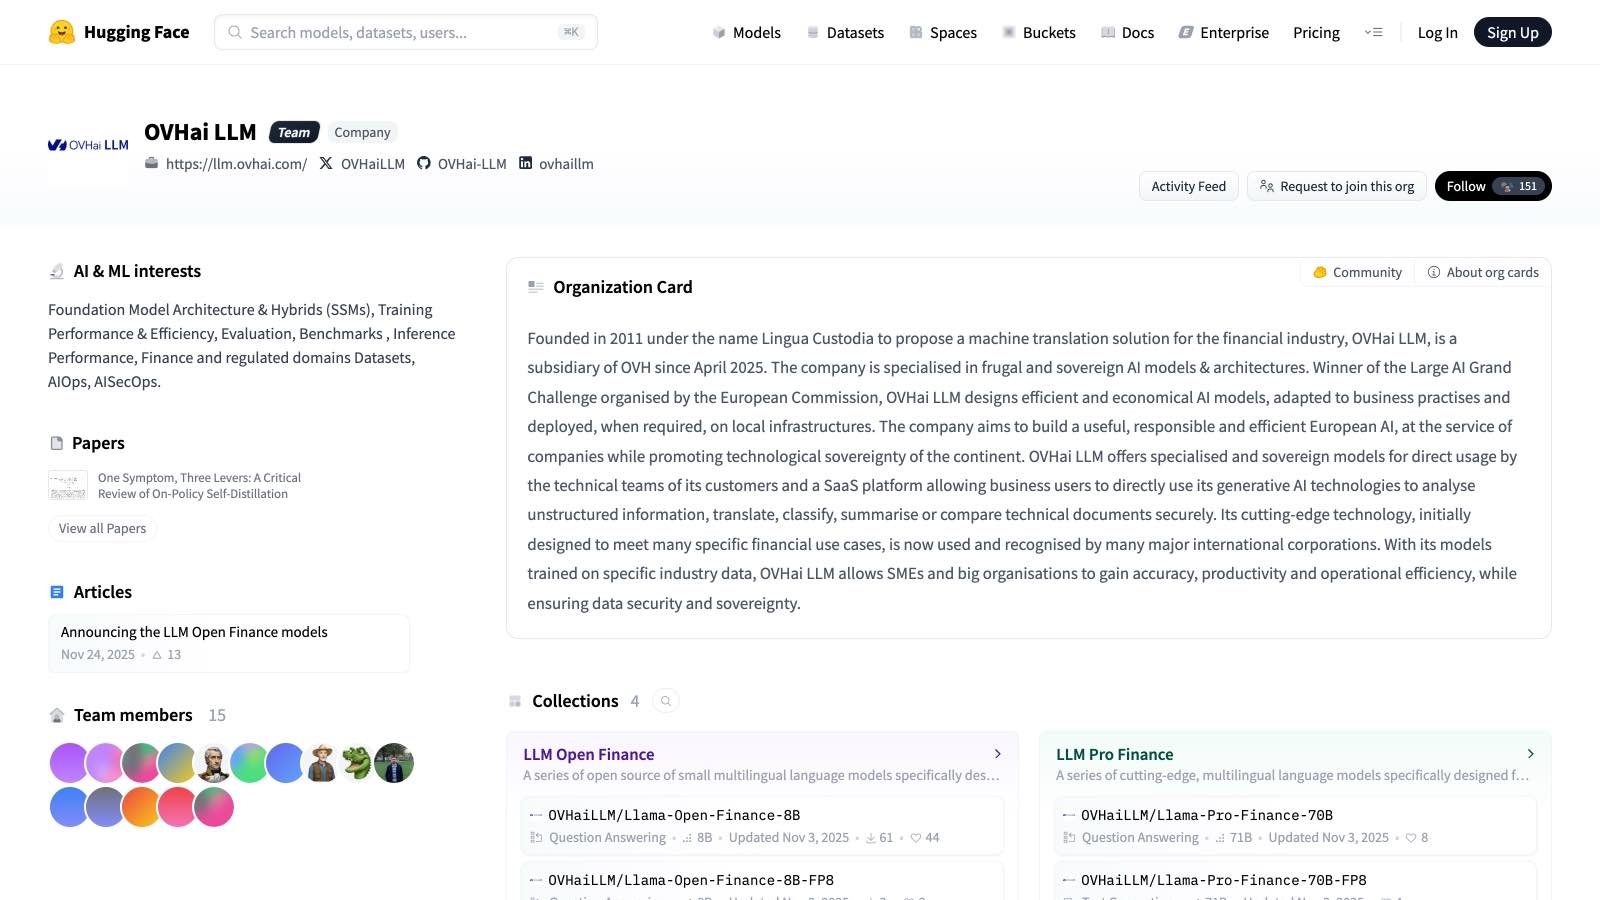
Le projet est porté par OVHai LLM, ex-Lingua Custodia puis ex-Dragon LLM, PME parisienne fondée en 2011 pour la traduction financière. Son rachat par OVHcloud, annoncé le 25 mars 2026, devait initier un lab d'entraînement de LLM souverains.
Sept milliards de paramètres, un milliard au travail
L'architecture annoncée repose sur 7 milliards de paramètres, dont 1 milliard activés à chaque requête et répartis entre 256 experts par couche.
OVH annonce 160 tokens par seconde sur une RTX A4500, et 50 tokens par seconde sur un simple processeur, sans GPU. Le processeur visé n'est pas précisé. À 16 bits, un modèle de cette taille pèse environ 14 Go, relève ActuIA : presque le double des 8 Go annoncés.
Les caractéristiques annoncées :
| Caractéristique | Annonce d'OVH |
|---|---|
| Paramètres | 7 milliards au total, 1 milliard activé par requête |
| Architecture | 256 experts par couche, attention hybride Differential-TPA et Mamba-3, format BF16 |
| Contexte | 32 000 tokens |
| Mémoire minimale | GPU avec 8 Go de mémoire |
| Débits annoncés | 160 tokens/s sur une RTX A4500 ; 50 tokens/s sur un simple processeur |
| Licence | Apache 2.0 |
Apache 2.0 et poids attendus jeudi
Olala mini sera disponible en open source sur Hugging Face, sous licence Apache 2.0 : le communiqué promet aussi les poids, un modèle de base pré-entraîné, un rapport technique et une documentation de conformité à l'AI Act. Pas de date au communiqué : selon l'AFP, les poids seront accessibles à partir de jeudi 19 novembre.
Le lancement officiel a lieu lors de l'OVHcloud AI Summit le 19 novembre, au Carrousel du Louvre à Paris. La keynote d'ouverture, de 10 h à 12 h, sera animée par Asha Sumputh en présence d'Octave Klaba et de Yaniv Fdida.
Aucun score de référence n'accompagne l'annonce : le rapport technique promis jeudi est le premier document qui pourrait en donner, et préciser les langues d'entraînement, absentes des annonces. Olala mini rejoindra Ministral 3 8B, un autre petit modèle français sous Apache 2.0, proposé par Mistral.
Trois supercalculateurs publics et un premier client, Qwant
L'entraînement a mobilisé trois supercalculateurs publics européens : Jupiter, MeluXina et Jean Zay, équipés de GPU GH200, A100 et H100. OVH chiffre ce soutien public à « l'équivalent de 7 M€ en heures de calcul » et remercie les pouvoirs publics.
Premier client cité, Qwant l'a adopté pour ses réponses flash : réponses 20 % plus rapides et coûts divisés par trois, face à un « modèle précédemment utilisé » non nommé. En octobre, Qwant indiquait à Next évaluer des alternatives après les évolutions tarifaires de Mistral ; ses réponses flash tournaient alors toujours sur des modèles Mistral.
Selon The Media Leader, Synfonium, la maison mère de Qwant, appartient majoritairement à Octave Klaba et à Miroslaw Klaba.
Après mini : 128 000 tokens puis plus de 100 milliards de paramètres
La feuille de route annonce une version 1.1 d'ici la fin de l'année, avec un contexte porté à 128 000 tokens et un raisonnement mathématique renforcé. La version 2.0 dépassera les 100 milliards de paramètres, avec des modèles spécialisés dans l'agentique d'entreprise, le DevOps cloud et la cybersécurité défensive comme offensive. À terme, Olala doit alimenter OVHai Workspace.
Selon l'AFP, OVHcloud vise 100 millions d'utilisateurs, sans échéance annoncée, et entend développer une suite de logiciels d'assistance à la programmation, dans l'esprit de Claude Code d'Anthropic, de Codex d'OpenAI ou de Vibe de Mistral. « Nous ne partons pas de zéro. Nous avons une base de clients, avec une marque OVH », résume Octave Klaba.
Jeudi reste la date à surveiller : publication annoncée des poids et du rapport technique, sur Hugging Face. Pour situer Olala, notre panorama des meilleures IA françaises fait le tour des acteurs et des modèles.
Pour le faire tourner chez vous, notre guide Quelle IA installer en local passe en revue les moteurs prêts à l'emploi et le matériel nécessaire pour chaque taille de modèle.