Filigrane OpenAI : les textes de ChatGPT bientôt marqués par défaut dans l'UE
Pour l'AI Act, OpenAI active son filigrane textGrain par défaut dans ChatGPT et Codex dans l'UE, en option dans l'API, et publie les chiffres de ses limites.
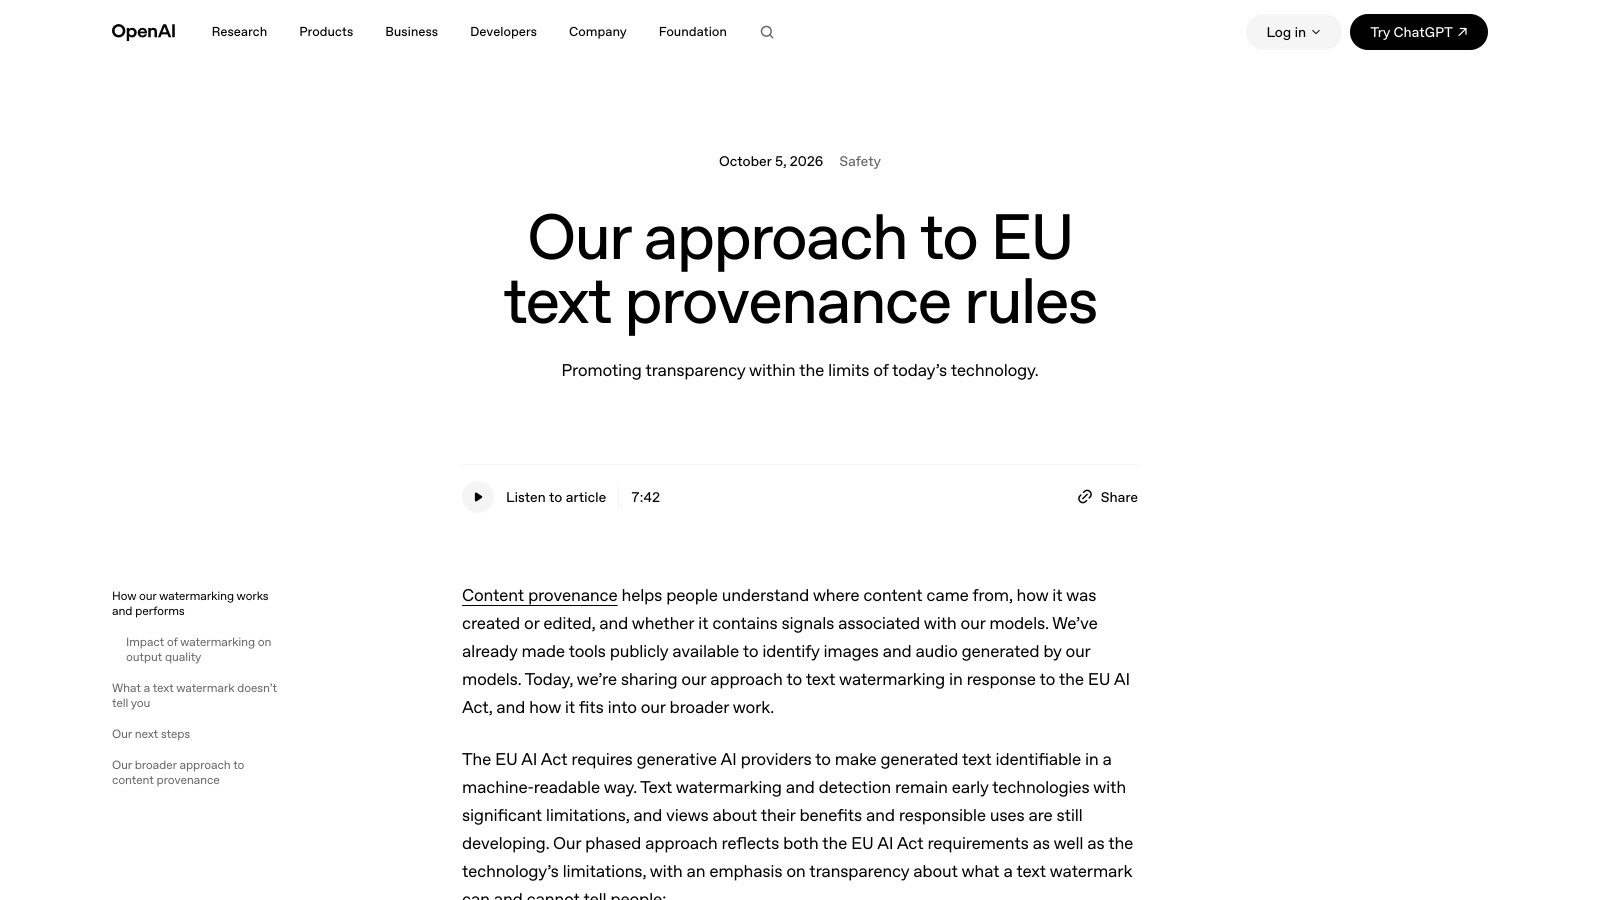
Lundi 5 octobre, OpenAI a publié un billet sobrement intitulé « Our approach to EU text provenance rules », notre approche des règles européennes de provenance du texte. Il y annonce textGrain, un filigrane invisible qui modifie très légèrement le choix des mots du modèle pour y déposer un signal statistique détectable. Dans l'Union européenne, ce marquage sera activé par défaut sur les textes éligibles de ChatGPT et Codex, « au cours des semaines à venir », sur tous les abonnements. Ailleurs, rien ne change par défaut, et l'API reste en opt-in.
C'est la première fois que l'éditeur de ChatGPT marque ses textes par défaut, et il le fait parce qu'une loi l'exige : les obligations de transparence du règlement européen sur l'IA, l'article 50, s'appliquent depuis le 2 août 2026. Le laboratoire publie en même temps les chiffres d'échec de son propre système, une rareté à mesurer avant de conclure quoi que ce soit sur la détection de textes IA.
Nous élargissons notre approche de la provenance des contenus au texte, en réponse aux exigences réglementaires européennes, tout en reconnaissant les limites importantes de la technologie actuelle de filigranage du texte. Nos outils aident déjà à vérifier si une image ou un fichier audio a été créé avec nos modèles. Ce travail s'appuie sur ces efforts pour aider chacun à mieux comprendre quand un contenu a pu être généré ou modifié avec un modèle OpenAI. Dans l'UE, nous commencerons à marquer les textes éligibles de ChatGPT et Codex au cours des semaines à venir, pour nous conformer à l'AI Act européen. Les clients de notre API peuvent activer le filigranage du texte pour certains modèles dans le monde entier dès aujourd'hui.Voir le post sur X
Un défaut inversé selon la juridiction
| Surface | Où | Statut au 7 octobre |
|---|---|---|
| ChatGPT et Codex (applications) | Union européenne | Activé par défaut « au cours des semaines à venir », tous abonnements éligibles |
| ChatGPT et Codex (applications) | Hors UE | Pas de défaut global au lancement ; proposée mais désactivée par défaut selon Ars Technica |
| API OpenAI | Monde entier | Opt-in depuis le 5 octobre, désactivé par défaut, réglable au niveau du projet ou de l'organisation |
| Modèles servis par des partenaires cloud | Monde entier | Annoncé « dans les semaines à venir » |
Le billet assume le choix, et sa formulation fait de l'Europe un terrain d'expérience.
Nous ne faisons pas du filigranage du texte un défaut mondial au lancement. Cette approche régionale nous donne la place d'apprendre d'un usage réel et de ses retours.Billet OpenAI, 5 octobre 2026 (traduit de l'anglais)
La comparaison avec le concurrent direct est éclairante : Anthropic a déployé un filigrane de texte similaire en août, mais activé mondialement, faute de moyen durable de limiter le marquage par région. OpenAI a choisi la découpe géographique : défaut dans l'UE où la loi l'exige, opt-in partout ailleurs. Selon le Wall Street Journal rapporté par TechCrunch, le laboratoire avait mis au point un filigrane dès 2024 mais en avait retardé la sortie, de crainte que ses utilisateurs ne migrent vers des concurrents qui ne marquent pas. La loi européenne a tranché ce calcul. Et Bruxelles devient, affaire après affaire, le régulateur de fait du laboratoire : OpenAI avait déjà dû déposer un rapport d'incident auprès de la Commission européenne en septembre.
92 %, 66 %, 17 % : le labo publie les chiffres de ses propres échecs
Le point le plus remarquable du billet n'est pas l'annonce, c'est ce qu'OpenAI dit de son efficacité. Sur des passages de 400 tokens, la détection atteint environ 92 % dans les meilleures conditions, avec un taux de faux positifs cible de 1 %. Remplacez 10 % des mots par des synonymes : elle tombe à 66 %. Remplacez 25 % des mots : elle s'effondre à 17 %. La longueur joue autant que l'édition, environ 80 % de détection sur des passages de 200 tokens contre environ 95 % à 400 tokens sur des contenus à choix de mots libres, et nettement moins sur les mathématiques, où le modèle a peu de latitude verbale. Le centre d'aide ajoute que la traduction peut rendre le filigrane indétectable.
Plusieurs reprises de presse font état d'une chute « de près de 75 % » de la détection quand on modifie « 20 % » du texte. Le billet d'OpenAI dit autre chose : les seuils testés sont 10 % et 25 % de mots remplacés par des synonymes, et la chute se mesure en points, de 92 % à 66 % puis à 17 %. Le chiffre de 75 correspond à l'écart entre 92 et 17, pas à un pourcentage relatif, et le seuil qui l'entraîne est 25 %, pas 20 %.
Le filigrane lui-même est décrit sans fard : un signal statistique invisible ajouté au choix des mots, sans caractères cachés ni ponctuation spéciale, qui voyage avec le texte copié-collé. Un rapport technique co-signé par des chercheurs des universités de Pennsylvanie et de Yale en détaille la mathématique, et OpenAI annonce vouloir ouvrir la technologie en open source. Dans ses évaluations, textGrain « égale ou dépasse » les autres approches testées, dont SynthID pour le texte, et les benchmarks de GPT-6 Astra ne changent pas de façon significative avec le marquage, 49,57 contre 49,76 points sur l'indice d'Artificial Analysis par exemple.
Le fil d'annonce sur X assume la même franchise.
Les filigranes ont des limites. Ils sont souvent indétectables, en particulier dans les passages courts. Réécrire ou traduire un texte peut supprimer complètement le filigrane. C'est pourquoi, pour l'instant, seuls des chercheurs approuvés auront accès à notre détecteur, pour nous aider à évaluer et améliorer la technologie. Nous traitons le filigranage du texte comme un domaine de recherche en cours. Nous continuerons à tester et à améliorer, avec les retours des utilisateurs, des développeurs, des décideurs publics et des chercheurs. https://openai.com/index/eu-text-provenance/Voir le post sur X
Un filigrane n'est pas un détecteur fiable
OpenAI l'écrit lui-même dans une section entière sur « ce qu'un filigrane de texte ne vous dit pas ». Une marque détectée n'indique ni la part d'intervention humaine, ni le propriétaire du texte, ni son auteur, ni sa véracité. Et l'absence de marque ne prouve pas une écriture humaine : un texte peut être trop court, édité, traduit, issu d'un modèle non couvert, antérieur au marquage, ou généré par un autre éditeur.
Le détecteur, lui, n'ouvrira pas au public. L'accès se demande sur candidature, examinée au cas par cas conformément au code de bonnes pratiques européen, et OpenAI travaille déjà avec un groupe restreint de chercheurs, dont John Thickstun à l'université Cornell et Martin Vechev à l'ETH Zurich et à l'INSAIT. Enseignants, éditeurs, recruteurs : rien à vérifier de votre côté, et les détecteurs commerciaux restent aussi peu fiables que ce que nous documentions dans notre guide sur la détection de textes IA. Pour situer textGrain dans le paysage, le tableau des filigranes en octobre 2026 vaut le détour.
| Éditeur | Support | Portée du défaut | Statut |
|---|---|---|---|
| OpenAI (textGrain) | Texte | UE (applications), opt-in mondial (API) | Déploiement « dans les semaines à venir » |
| Anthropic | Texte | Mondial | Actif depuis août, premier modèle marqué début septembre, détecteur en aperçu privé |
| Google (Gemini) | Images, vidéos, musiques | Mondial, devenu optionnel le 14 août | Marque visible, désactivable par réglage |
| SynthID (Google DeepMind) | Images et audio | Invisible | Intégré par Google et déjà par OpenAI pour ses images et audio |
Détail qui en dit long sur l'imbrication du secteur : les images et l'audio générés par les outils d'OpenAI portent déjà le SynthID de Google DeepMind, en plus des Content Credentials du standard C2PA. Sur le texte, chaque éditeur roule sa propre méthode, aucune n'est vérifiable par des tiers.
Même parfaitement déployé, le filigrane répond à une seule question : ce passage contient-il probablement le signal d'un modèle OpenAI ? Il ne dit pas qui a écrit, ni combien, ni si c'est vrai, ni qui est responsable. Il ne couvre pas les autres éditeurs, ni les modèles antérieurs, ni les textes retravaillés. Et tant que le détecteur reste fermé, il ne permet même pas cette unique réponse en dehors d'un cercle approuvé. L'obligation réglementaire est satisfaite, la détection fiable de textes IA reste un problème ouvert.
Si vous publiez du contenu assisté par IA, ne comptez ni sur le filigrane ni sur un détecteur pour prouver quoi que ce soit. Documentez votre chaîne de production, qui rédige, qui relit, quel outil intervient et où : c'est cette traçabilité qui vaut preuve, pas un score de détection.
Questions fréquentes
Mes textes ChatGPT seront-ils marqués en France ?
Oui, sans action de votre part : la France relève du périmètre européen, et le filigrane sera activé par défaut dans ChatGPT et Codex « au cours des semaines à venir ». Le billet ne décrit aucun réglage pour le retirer dans les applications ; sur l'API, il reste en opt-in.
Peut-on vérifier soi-même si un texte porte le filigrane ?
Non. Le détecteur n'est pas public : l'accès se demande sur candidature, accordée au cas par cas à des chercheurs et organisations approuvés.
Le filigrane survit-il au copier-coller ?
Oui, puisqu'il réside dans le choix des mots et non dans des métadonnées. Mais il s'affaiblit à l'édition : environ 92 % de détection sur un passage de 400 tokens, 66 % après remplacement de 10 % des mots, 17 % après 25 %.
Claude et Gemini sont-ils concernés ?
Anthropic marque les textes de Claude mondialement depuis août ; Google marque les contenus visuels de Gemini avec une marque visible devenue optionnelle.